記事一覧
ブログ(無料版)の仕様で、デフォルトのトップページだと投稿記事の1つ1つが全部表示されてしまい、ブログ全体を把握しづらい。下記のリンクから入ったほうが記事を探しやすいかも。このブログをブックマークする際も下記リンクをブックマークすることをオススメする。
ブログ(無料版)の仕様で、デフォルトのトップページだと投稿記事の1つ1つが全部表示されてしまい、ブログ全体を把握しづらい。下記のリンクから入ったほうが記事を探しやすいかも。このブログをブックマークする際も下記リンクをブックマークすることをオススメする。
※更新情報
- 2026年10月12日 index.pyを更新(画像を追加した場合、追加した画像の差分だけインデックスを作成するようにチャッピーに修正してもらった。)
Googleフォトでは画像をアップロードしておけば、「バイク」などのキーワードで画像を検索してくれるのでとても便利。
だけど、このまま画像をアップロードし続けると、容量がどんどん増加、Googleへの課金が止められない…。
さらに何かのきっかけでGoogleアカウントがBANされて、Googleフォトにアクセスできなくなる、なんてことになるかもしれない…。
そこでローカルでGoogleフォトのようにキーワード検索してくれる環境をチャッピー(ChatGPT)に考えてもらった。
プロジェクトは ~/photo-search に配置します。
~/photo-search/
├── .venv/ # Python仮想環境
├── images/ # 検索対象の画像
├── templates/
│ └── index.html # ブラウザー画面
├── index.py # 画像インデックス作成
├── search_server.py # 検索サーバー
├── embeddings.npy # 画像の特徴ベクトル(python index.py後に生成される)
├── index_metadata.json # python index.py後に生成される
└── paths.json # 画像ファイルのパス一覧(python index.py後に生成される)
images/ には JPEG、PNG、WebP などの画像を保存。
sudo apt update
sudo apt install -y python3 python3-venv python3-pip
「photo-search」ディレクトリ内でターミナルを開いて、Pythonの仮想環境のvenvを作成。
python3 -m venv .venv
source .venv/bin/activate
仮想環境を有効にすると、ターミナルの先頭に (.venv) と表示される。
以下は、上述のsource .venv/bin/activateをした仮想環境化での実行。
python -m pip install --upgrade pip

python -m pip install torch==2.2.2 torchvision==0.17.2 \
  --index-url https://download.pytorch.org/whl/cpu

python -m pip install \
    "transformers==4.39.1" \
    flask \
    "numpy==1.26.4" \
    "timm==0.9.16" \
    pillow \
    sentencepiece
3-4. インストール確認
python -c "import torch; print(torch.__version__)"
python -c "import transformers; print(transformers.__version__)"
python -c "import flask, numpy; print('基本ライブラリー OK')"
「photo-search」ディレクトリ内に、以下のファイルを配置。ファイル名の中身は後述。
「templates」ディレクトリを作成し、中にindex.htmlを配置。
画像を検索するために、あらかじめ画像の特徴ベクトルを作成。
「images」ディレクトリに画像を入れる。
「photo-search」ディレクトリ内でターミナルを開いて、仮想環境を有効にする(すでにターミナルの先頭に (.venv)と表示されていれば、しなくてよい)。
source .venv/bin/activate
画像インデックスの作成
python index.py
大量の画像のインデックス化にはすごい時間がかかるので気長に待つ。
index.py では、今回使用しているモデル line-corporation/clip-japanese-base-v2 で画像をベクトル化し、次の3ファイルが生成される。
すでに作成済みのインデックスがある場合は、この工程を繰り返す必要はない。
画像を追加・削除したときに、インデックスを作り直す。
この構成では、サーバー起動時にAIモデルを一度読み込む。
毎回の利用では、次のコマンドで起動。
「photo-search」ディレクトリ内でターミナルを開いて、仮想環境を有効にする(すでにターミナルの先頭に (.venv)と表示されていれば、しなくてよい)。
source .venv/bin/activate
サーバー起動。
python -u search_server.py
モデルの読み込みが完了すると、次のような表示になる。
モデル読み込み完了
ブラウザーで http://127.0.0.1:8000 を開いてください。
 * Running on http://127.0.0.1:8000
そのままサーバーを起動しておく。
ブラウザで http://127.0.0.1:8000 を開く。
検索欄に日本語のキーワードを入力し、「検索」を押す。
サーバーを終了するときは、起動したターミナルで Ctrl+C 。
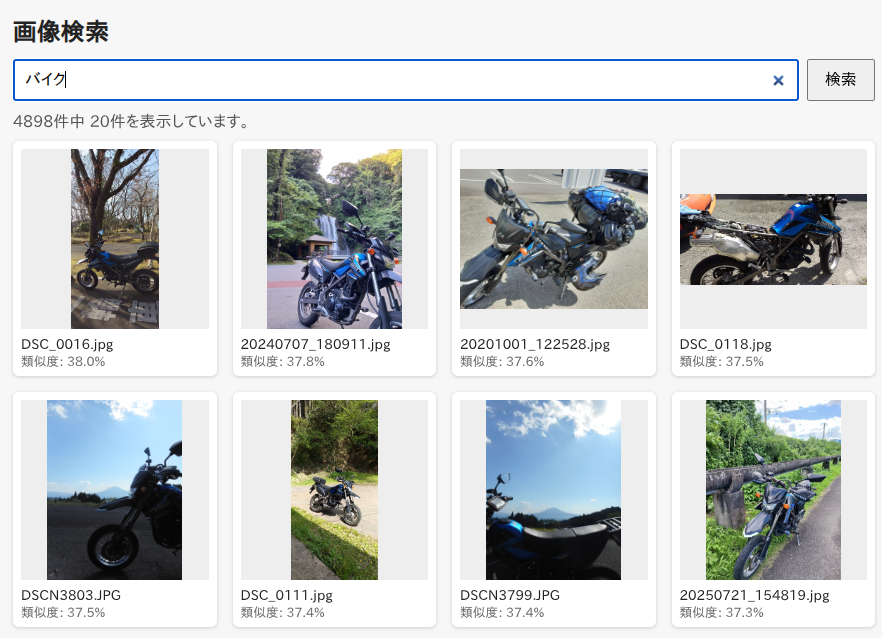
通常の検索:サーバーを起動してブラウザーで検索するだけ。
画像を追加したとき:index.py を実行してインデックスを更新し、サーバーを再起動する。
初回のモデル取得:インターネット接続が必要。モデルの取得後は、必要なファイルがローカルに残っていれば、通常の検索処理はローカルで実行できる。
from pathlib import Path
import json
import os

import numpy as np
import torch
from PIL import Image
from tqdm import tqdm
from transformers import AutoModel, AutoImageProcessor


# =========================
# 設定
# =========================

BASE_DIR = Path(__file__).resolve().parent

IMAGE_DIR = BASE_DIR / "images"
EMBEDDINGS_FILE = BASE_DIR / "embeddings.npy"
PATHS_FILE = BASE_DIR / "paths.json"
METADATA_FILE = BASE_DIR / "index_metadata.json"

MODEL_NAME = "line-corporation/clip-japanese-base-v2"
DEVICE = "cpu"

torch.set_num_threads(4)
torch.set_num_interop_threads(1)

# Pentium Gold G5420向け
BATCH_SIZE = 4

EXTENSIONS = {
    ".jpg", ".jpeg", ".png", ".webp",
    ".bmp", ".tif", ".tiff",
}


# =========================
# ファイル情報
# =========================

def file_info(path):
    """画像の更新日時とファイルサイズを取得する。"""
    stat = path.stat()

    return {
        "size": stat.st_size,
        "mtime_ns": stat.st_mtime_ns,
    }


def relative_path(path):
    """プロジェクトフォルダからの相対パスを返す。"""
    return path.relative_to(BASE_DIR).as_posix()


def save_json_atomic(path, data):
    """JSONを一時ファイルに書いてから置き換える。"""
    temp_path = path.with_name(path.name + ".tmp")

    with open(temp_path, "w", encoding="utf-8") as f:
        json.dump(
            data,
            f,
            ensure_ascii=False,
            indent=2,
        )

    os.replace(temp_path, path)


# =========================
# 画像一覧
# =========================

IMAGE_DIR.mkdir(parents=True, exist_ok=True)

current_paths = sorted(
    (
        p for p in IMAGE_DIR.rglob("*")
        if p.is_file()
        and p.suffix.lower() in EXTENSIONS
    ),
    key=lambda p: relative_path(p),
)

current_keys = {
    relative_path(p): p
    for p in current_paths
}

print(f"画像枚数: {len(current_paths)}")


# =========================
# 既存インデックスの読み込み
# =========================

old_vectors = {}
old_metadata = {}
old_model_name = None
full_rebuild = True

if (
    EMBEDDINGS_FILE.is_file()
    and PATHS_FILE.is_file()
    and METADATA_FILE.is_file()
):
    try:
        old_embeddings = np.load(
            EMBEDDINGS_FILE,
            allow_pickle=False,
        )

        with open(PATHS_FILE, encoding="utf-8") as f:
            old_paths = json.load(f)

        with open(METADATA_FILE, encoding="utf-8") as f:
            metadata = json.load(f)

        old_model_name = metadata.get("model_name")
        old_metadata = metadata.get("files", {})

        if (
            old_embeddings.ndim == 2
            and len(old_embeddings) == len(old_paths)
            and old_model_name == MODEL_NAME
        ):
            old_vectors = {
                str(path): old_embeddings[i]
                for i, path in enumerate(old_paths)
            }

            full_rebuild = False

            print(
                f"既存インデックス: {len(old_vectors)} 件"
            )

        else:
            print(
                "モデル名またはインデックス形式が異なるため、"
                "全件を再作成します。"
            )

    except Exception as e:
        print(f"既存インデックスを読み込めません: {e}")
        print("全件を再作成します。")

else:
    print(
        "既存の差分管理情報がないため、"
        "初回インデックスを作成します。"
    )


# =========================
# 差分の判定
# =========================

if full_rebuild:
    vectors_by_path = {}
    paths_to_process = list(current_paths)

else:
    # 現在も存在する画像だけを引き継ぐ。
    # 削除済み画像はここで除外される。
    vectors_by_path = {
        key: old_vectors[key]
        for key in current_keys
        if key in old_vectors
    }

    paths_to_process = []

    for path in current_paths:
        key = relative_path(path)

        previous_info = old_metadata.get(key)

        try:
            current_info = file_info(path)
        except OSError as e:
            print(f"ファイル情報を取得できません: {path}: {e}")
            continue

        # 新規画像・変更画像・ベクトルのない画像を処理する。
        if (
            key not in old_vectors
            or previous_info != current_info
        ):
            paths_to_process.append(path)

    removed = set(old_vectors) - set(current_keys)

    print(f"新規・変更画像: {len(paths_to_process)} 枚")
    print(f"削除された画像: {len(removed)} 枚")


# =========================
# 変更がなければ終了
# =========================

if not paths_to_process:
    if not full_rebuild:
        print("変更された画像はありません。")
        print("インデックスの更新は不要です。")

        # 削除画像があった場合は、残った画像だけで保存し直す。
        final_keys = [
            relative_path(p)
            for p in current_paths
            if relative_path(p) in vectors_by_path
        ]

        if set(final_keys) != set(old_vectors):
            old_dim = old_embeddings.shape[1]

            new_embeddings = np.stack([
                vectors_by_path[key]
                for key in final_keys
            ]) if final_keys else np.empty(
                (0, old_dim),
                dtype=np.float32,
            )

            temp_embeddings = BASE_DIR / "embeddings.tmp.npy"

            np.save(
                temp_embeddings,
                new_embeddings.astype(np.float32),
            )
            os.replace(temp_embeddings, EMBEDDINGS_FILE)

            save_json_atomic(PATHS_FILE, final_keys)

            new_metadata = {
                "model_name": MODEL_NAME,
                "embedding_dim": old_dim,
                "files": {
                    key: file_info(current_keys[key])
                    for key in final_keys
                },
            }

            save_json_atomic(METADATA_FILE, new_metadata)

            print("削除された画像をインデックスから除外しました。")

        raise SystemExit(0)


# =========================
# モデル読み込み
# =========================

print("モデルを読み込んでいます...")
print(MODEL_NAME)

processor = AutoImageProcessor.from_pretrained(
    MODEL_NAME,
    trust_remote_code=True,
)

model = AutoModel.from_pretrained(
    MODEL_NAME,
    trust_remote_code=True,
)

model.to(DEVICE)
model.eval()

print("モデル読み込み完了")


# =========================
# 変更画像のベクトル化
# =========================

failed_paths = set()

for start in tqdm(
    range(0, len(paths_to_process), BATCH_SIZE),
    desc="変更画像を解析中",
):
    batch_paths = paths_to_process[
        start:start + BATCH_SIZE
    ]

    images = []
    valid_paths = []

    # -------------------------
    # 画像読み込み
    # -------------------------

    for path in batch_paths:
        try:
            with Image.open(path) as image:
                images.append(image.convert("RGB"))

            valid_paths.append(path)

        except Exception as e:
            print()
            print(f"画像の読み込み失敗: {path}")
            print(e)

            failed_paths.add(relative_path(path))

            # 変更画像が読み込めない場合、
            # 古いベクトルを残さない。
            vectors_by_path.pop(relative_path(path), None)

    if not images:
        continue

    # -------------------------
    # 画像前処理
    # -------------------------

    inputs = processor(
        images=images,
        return_tensors="pt",
    )

    inputs = {
        key: value.to(DEVICE)
        for key, value in inputs.items()
    }

    # -------------------------
    # 画像 → ベクトル
    # -------------------------

    with torch.no_grad():
        features = model.get_image_features(**inputs)

    if hasattr(features, "pooler_output"):
        features = features.pooler_output

    if features.ndim != 2:
        raise RuntimeError(
            f"想定外の特徴ベクトル形状です: {features.shape}"
        )

    # -------------------------
    # L2正規化
    # -------------------------

    features = features / features.norm(
        dim=-1,
        keepdim=True,
    ).clamp_min(1e-12)

    feature_array = features.cpu().numpy().astype(np.float32)

    # 既存ベクトルと次元が異なる場合は混在させない。
    if vectors_by_path:
        existing_dim = next(iter(vectors_by_path.values())).shape[0]

        if feature_array.shape[1] != existing_dim:
            raise RuntimeError(
                "既存ベクトルと新規ベクトルの次元数が異なります。"
                "モデル名や既存インデックスを確認してください。"
            )

    for path, vector in zip(valid_paths, feature_array):
        vectors_by_path[relative_path(path)] = vector


# =========================
# 保存対象を確定
# =========================

final_keys = [
    relative_path(path)
    for path in current_paths
    if relative_path(path) in vectors_by_path
]

if not final_keys:
    raise RuntimeError(
        "保存できる画像ベクトルがありません。"
    )

embeddings = np.stack([
    vectors_by_path[key]
    for key in final_keys
]).astype(np.float32)

if embeddings.ndim != 2:
    raise RuntimeError(
        f"保存するベクトルの形状が不正です: {embeddings.shape}"
    )


# =========================
# インデックス保存
# =========================

# まず一時ファイルに保存してから置き換える。
temp_embeddings = BASE_DIR / "embeddings.tmp.npy"

np.save(
    temp_embeddings,
    embeddings,
)

os.replace(temp_embeddings, EMBEDDINGS_FILE)

save_json_atomic(
    PATHS_FILE,
    final_keys,
)

new_metadata = {
    "model_name": MODEL_NAME,
    "embedding_dim": int(embeddings.shape[1]),
    "files": {
        key: file_info(current_keys[key])
        for key in final_keys
    },
}

save_json_atomic(
    METADATA_FILE,
    new_metadata,
)


# =========================
# 完了
# =========================

print()
print("インデックス更新完了")
print(f"モデル: {MODEL_NAME}")
print(f"処理した画像: {len(paths_to_process)} 枚")
print(f"読み込みに失敗した画像: {len(failed_paths)} 枚")
print(f"登録ベクトル数: {len(embeddings)}")
print(f"ベクトル次元数: {embeddings.shape[1]}")
print(f"ベクトル保存先: {EMBEDDINGS_FILE}")
print(f"画像一覧: {PATHS_FILE}")
print(f"差分管理情報: {METADATA_FILE}")
import json
import logging
from pathlib import Path

import numpy as np
import torch
from transformers import AutoModel, AutoTokenizer
from flask import Flask, request, jsonify, render_template, send_file, abort


# =========================
# 設定
# =========================

MODEL_NAME = "line-corporation/clip-japanese-base-v2"

BASE_DIR = Path(__file__).resolve().parent
EMBEDDINGS_FILE = BASE_DIR / "embeddings.npy"
PATHS_FILE = BASE_DIR / "paths.json"

DEVICE = "cpu"

torch.set_num_threads(4)
torch.set_num_interop_threads(1)

app = Flask(__name__)
logging.basicConfig(level=logging.INFO)


# =========================
# インデックス読み込み
# =========================

print("インデックスを読み込んでいます...", flush=True)

embeddings = np.load(EMBEDDINGS_FILE)

with open(PATHS_FILE, encoding="utf-8") as f:
    paths = json.load(f)

if len(embeddings) != len(paths):
    raise RuntimeError("ベクトル数と画像パス数が一致していません。")

# インデックスに登録された画像の実際のパスを保存
resolved_paths = []

for path in paths:
    p = Path(path)

    if not p.is_absolute():
        p = BASE_DIR / p

    resolved_paths.append(p.resolve())

print(f"インデックス読み込み完了: {len(paths)} 枚", flush=True)


# =========================
# モデル読み込み
# =========================

print("モデルを読み込んでいます...", flush=True)

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_NAME,
    trust_remote_code=True,
)

model = AutoModel.from_pretrained(
    MODEL_NAME,
    trust_remote_code=True,
)

model.to(DEVICE)
model.eval()

print("モデル読み込み完了", flush=True)


# =========================
# 検索処理
# =========================


def search_images(query, number=None):
    text_inputs = tokenizer(
        [query],
        padding=True,
        truncation=True,
    )

    text_inputs = {
        key: (
            value.to(DEVICE)
            if isinstance(value, torch.Tensor)
            else torch.tensor(value).to(DEVICE)
        )
        for key, value in text_inputs.items()
    }

    with torch.no_grad():
        query_vector = model.get_text_features(**text_inputs)

    query_vector = query_vector / query_vector.norm(
        dim=-1,
        keepdim=True,
    ).clamp_min(1e-12)

    query_vector = query_vector.cpu().numpy()[0]

    scores = embeddings @ query_vector

    # 類似度の高い順に並べる
    indices = np.argsort(-scores)

    # 件数が指定されている場合だけ制限する
    if number is not None:
        number = max(1, min(int(number), len(paths)))
        indices = indices[:number]

    results = []

    for index in indices:
        index = int(index)

        results.append({
            "index": index,
            "filename": resolved_paths[index].name,
            "score": float(scores[index]),
            "image_url": f"/image/{index}",
        })

    return results


# =========================
# ブラウザー画面
# =========================

@app.route("/")
def home():
    return render_template("index.html")


# =========================
# 検索 API
# =========================

@app.route("/search")
def search():
    query = request.args.get("q", "").strip()

    if not query:
        return jsonify([])

    try:
        results = search_images(query, number=None)
        return jsonify(results)

    except Exception:
        app.logger.exception("検索中にエラーが発生しました")
        return jsonify({"error": "検索中にエラーが発生しました。"}), 500


# =========================
# 画像配信
# =========================

@app.route("/image/<int:index>")
def image(index):
    if index < 0 or index >= len(resolved_paths):
        abort(404)

    image_path = resolved_paths[index]

    # インデックスに登録されたファイルだけを配信
    if not image_path.is_file():
        abort(404)

    return send_file(image_path)


# =========================
# 起動
# =========================

if __name__ == "__main__":
    print("ブラウザーで http://127.0.0.1:8000 を開いてください。", flush=True)

    app.run(
        host="127.0.0.1",
        port=8000,
        debug=False,
        use_reloader=False,
    )
<!DOCTYPE html>
<html lang="ja">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1">
    <title>画像検索</title>

    <style>
        body {
            font-family: sans-serif;
            margin: 20px;
            background: #f7f7f7;
            color: #222;
        }

        h1 {
            font-size: 1.5rem;
        }

        .search-area {
            display: flex;
            gap: 8px;
            margin-bottom: 12px;
        }

        #query {
            flex: 1;
            min-width: 0;
            padding: 10px;
            font-size: 1rem;
        }

        button {
            padding: 10px 16px;
            font-size: 1rem;
            cursor: pointer;
        }

        #status {
            margin: 12px 0;
            color: #555;
        }

        #results {
            display: grid;
            grid-template-columns: repeat(
                auto-fill,
                minmax(180px, 1fr)
            );
            gap: 16px;
        }

        .item {
            background: white;
            border-radius: 6px;
            padding: 8px;
            box-shadow: 0 1px 4px #ccc;
            min-width: 0;
        }

        .item a {
            color: inherit;
            text-decoration: none;
        }

        .item img {
            width: 100%;
            height: 180px;
            object-fit: contain;
            background: #eee;
            display: block;
        }

        .filename {
            font-size: 0.85rem;
            overflow-wrap: anywhere;
            margin-top: 8px;
        }

        .score {
            font-size: 0.8rem;
            color: #666;
            margin-top: 4px;
        }

        #loadMore {
            display: none;
            margin: 24px auto;
        }
    </style>
</head>

<body>
    <h1>画像検索</h1>

    <form id="searchForm">
        <div class="search-area">
            <input
                id="query"
                type="search"
                placeholder="検索語を入力"
                required
            >
            <button type="submit">検索</button>
        </div>
    </form>

    <div id="status" role="status">検索語を入力してください。</div>

    <div id="results"></div>

    <button id="loadMore" type="button">
        さらに読み込む(20件)
    </button>

    <script>
        const PAGE_SIZE = 20;

        const form = document.getElementById("searchForm");
        const queryInput = document.getElementById("query");
        const resultsArea = document.getElementById("results");
        const statusArea = document.getElementById("status");
        const loadMoreButton = document.getElementById("loadMore");

        let allResults = [];
        let displayedCount = 0;
        let searchGeneration = 0;

        form.addEventListener("submit", async (event) => {
            event.preventDefault();

            const query = queryInput.value.trim();
            if (!query) return;

            const generation = ++searchGeneration;

            allResults = [];
            displayedCount = 0;
            resultsArea.replaceChildren();
            loadMoreButton.style.display = "none";
            statusArea.textContent = "検索中です...";

            try {
                const response = await fetch(
                    "/search?q=" + encodeURIComponent(query)
                );

                if (!response.ok) {
                    throw new Error("検索APIでエラーが発生しました。");
                }

                const data = await response.json();

                // 新しい検索が始まっていたら古い結果を破棄
                if (generation !== searchGeneration) return;

                if (!Array.isArray(data)) {
                    throw new Error(
                        data.error || "検索結果を取得できませんでした。"
                    );
                }

                allResults = data;

                if (allResults.length === 0) {
                    statusArea.textContent = "該当する画像はありません。";
                    return;
                }

                showMore();

            } catch (error) {
                if (generation !== searchGeneration) return;

                statusArea.textContent = error.message;
            }
        });

        function showMore() {
            const start = displayedCount;
            const end = Math.min(
                start + PAGE_SIZE,
                allResults.length
            );

            const fragment = document.createDocumentFragment();

            for (let i = start; i < end; i++) {
                const result = allResults[i];

                const item = document.createElement("div");
                item.className = "item";

                const link = document.createElement("a");
                link.href = result.image_url;
                link.target = "_blank";
                link.rel = "noopener";

                const img = document.createElement("img");
                img.src = result.image_url;
                img.alt = result.filename;
                img.loading = "lazy";

                const filename = document.createElement("div");
                filename.className = "filename";
                filename.textContent = result.filename;

                const score = document.createElement("div");
                score.className = "score";
                score.textContent =
                    "類似度: " + (result.score * 100).toFixed(1) + "%";

                link.appendChild(img);
                item.appendChild(link);
                item.appendChild(filename);
                item.appendChild(score);

                fragment.appendChild(item);
            }

            resultsArea.appendChild(fragment);
            displayedCount = end;

            statusArea.textContent =
                allResults.length + "件中 " +
                displayedCount + "件を表示しています。";

            if (displayedCount < allResults.length) {
                loadMoreButton.style.display = "block";
                loadMoreButton.textContent =
                    "さらに読み込む(残り" +
                    (allResults.length - displayedCount) + "件)";
            } else {
                loadMoreButton.style.display = "none";
            }
        }

        loadMoreButton.addEventListener("click", showMore);
    </script>
</body>
</html>
個人情報保護の観点から、氏名等の個人情報をアップロードしないために、マークシートの解答用紙(PDF)から解答部分だけを切り抜いたPDFを作成して、それをGemini Notebook(旧NotebookLM)に採点してもらう。
※ChatGPTに作成してもらった。
import sys
import fitz

# 使い方:
# python pdfcrop.py input.pdf output.pdf x1 y1 x2 y2 [dpi]

if len(sys.argv) not in (7, 8):
    print("Usage:")
    print("  python pdfcrop.py input.pdf output.pdf x1 y1 x2 y2 [dpi]")
    sys.exit(1)

input_pdf = sys.argv[1]
output_pdf = sys.argv[2]

# 300dpi画像上で確認した座標(px)
x1 = int(sys.argv[3])
y1 = int(sys.argv[4])
x2 = int(sys.argv[5])
y2 = int(sys.argv[6])

# dpi省略時は300
dpi = int(sys.argv[7]) if len(sys.argv) == 8 else 300

# px → PDF内部座標(pt)
scale = 72 / dpi

rect = fitz.Rect(
    x1 * scale,
    y1 * scale,
    x2 * scale,
    y2 * scale
)

doc = fitz.open(input_pdf)

for page in doc:
    page.set_cropbox(rect)

doc.save(output_pdf)

print(f"Saved: {output_pdf}")
ScanSnapや複合機(コピー機)で、スキャンしてPDF化。
スキャン時の設定を、 300 dpi にする。
個人情報を除いた、解答部分だけの範囲を指定する。
PDFを画像編集ソフトGimpで開き(開くのは1ページ分だけで良い)、切り取る 左上 座標と 右下 座標を確認し、メモを取っておく。
※ PDFを開く際に、解像度を 300ピクセルにして開く 。
input.pdfと同じフォルダ内にpdfcrop.pyファイルを配置して、フォルダ内で右クリック>「ターミナルで開く」でpowershellを開いて、以下のように実行。本当に解答部分だけになったのかを確認。
python3 pdfcrop.py input.pdf output.pdf 100 600 2300 2800
※上記コマンドは、切り取る座標が左上(100 , 600)、右下(2300 , 2800)の場合。
適宜、Gimpで確認した座標の数値を入力する。
Gemini Notebookに、以下の2つのPDFをアップロードする。
正答・配点のPDFは例えば、以下のような内容とする。
Q1 4 (2 点)
Q2 2 (2 点)
Q3 1 (2 点)
︙
以下のような指示をプロンプトとして入力。
「正答・配点.pdf」をもとに、「試験解答.pdf」を採点してください。
「試験解答.pdf」の黒く塗りつぶした部分が回答です。
1ページが1名分の解答です。

ページ,合計点,Q1,Q2,Q3,Q4,Q5,…Q20
のようなcsv形式で出力して。
以下のようにcsv形式の結果が表示されるはず。
「正答・配点.pdf」に基づき、「試験解答.pdf」の全100ページの採点結果をCSV形式で出力します。

ページ,合計点,Q1,Q2,Q3,Q4,Q5,Q6,Q7,Q8,Q9,Q10,Q11,Q12,Q13,Q14,Q15,Q16,Q17,Q18
1,28,0,2,2,2,2,4,4,2,0,0,2,0,2,2,2,0,0,2
2,26,0,2,0,2,2,4,4,2,2,0,0,0,2,2,2,0,2,0
︙
出力された結果をコピーして、「メモ帳」を開き、コピペしてcsvファイルとして保存(名前をつけて保存>エンコードをANSIにする)。
保存したcsvファイルをExcelで開く。
各ページのレイアウトが全て同じのPDFデータから、全てのページ、特定の範囲だけ切り抜きたい(トリミングしたい)ときに便利。
ChatGPTさんに考えてもらった。
pythonをインストール。自分で調べて。
pymupdfライブラリをインストール。
pip install pymupdf
PDFをGimpで開き(開くのは1ページ分だけで良い)、切り取る左上座標と右下座標を確認。
※PDFを開く際に、解像度を300ピクセルにして開く。
pdfcrop.pyスクリプトを実行。スクリプトの内容は後述の通り。
python3 pdfcrop.py input.pdf output.pdf 100 600 2300 2800
※上記は、切り取る座標が左上(100 , 600)、右下(2300 , 2800)の場合。
import sys
import fitz

# 使い方:
# python pdfcrop.py input.pdf output.pdf x1 y1 x2 y2 [dpi]

if len(sys.argv) not in (7, 8):
    print("Usage:")
    print("  python pdfcrop.py input.pdf output.pdf x1 y1 x2 y2 [dpi]")
    sys.exit(1)

input_pdf = sys.argv[1]
output_pdf = sys.argv[2]

# 300dpi画像上で確認した座標(px)
x1 = int(sys.argv[3])
y1 = int(sys.argv[4])
x2 = int(sys.argv[5])
y2 = int(sys.argv[6])

# dpi省略時は300
dpi = int(sys.argv[7]) if len(sys.argv) == 8 else 300

# px → PDF内部座標(pt)
scale = 72 / dpi

rect = fitz.Rect(
    x1 * scale,
    y1 * scale,
    x2 * scale,
    y2 * scale
)

doc = fitz.open(input_pdf)

for page in doc:
    page.set_cropbox(rect)

doc.save(output_pdf)

print(f"Saved: {output_pdf}")
リアブレーキの踏んだ感覚が緩くなってきた気がしたので、ブレーキフルードの交換をしてきた。
2026年5月2日 約22,100km
…全然、距離が伸びてない。 バイク乗れてないなぁ。
ほとんど参照リンクのとおり。
cygwinでchereをインストール。
管理者権限でcygwinを起動して、以下を実行。
chere -i -s bash -e "Cygwin Here(&B)" -t mintty
エクスプローラーで右クリック>その他のオプションを確認>「Cygwin Here(B)」というメニューが入っているはず。
または、エクスプローラーで Shift + 右クリック>「Cygwin Here(B)」。
※以前の記事(NDLOCR-LiteでOCRして、透明テキストの付いたPDFを作成(端末だけで実行))の方法で、コマンドライン(Powershell)のみでできるようにしたが、実行には複数回コマンドを打たなければいけなかった。
今回の記事では、コマンドを打つ回数は1回で、さらに画像の傾きの自動補正(斜めになっているのをまっすぐにする)工程を追加したスクリプトとなっている(Geminiに作成してもらった)。
※ただし、縦書きOCRでしか試していないので、横書きOCRがうまく機能するかは試していないので、あしからず。
国立国会図書館(NDL)がGPUを必要としないOCRツール NDLOCR-Liteアプリケーション を公開した。 https://github.com/ndl-lab/ndlocr-lite
これを利用すると、紙ベースで書類等をスキャンしたPDFデータをOCRできるだけでなく、PDFに透明テキストをつけることができる。
初心者がPythonを入れるのは、Microsoft Storeからインストールのが一番楽だと思うのだが、Store版は一部ツールとの相性が良くないらしいので、公式版をインストールしたほうがいいらしい。下記サイトを参照に。
なお、NDLOCR-Liteのコマンドラインから操作を行うにはPython 3.10以上が必要とのこと。
それ以上のバージョンでできるだけ最新のものをインストールしておけば大丈夫だとは思う…。
Pythonをインストール後、別途各種ライブラリを、Powershellで以下を実行してインストール。
pip install pymupdf reportlab pillow
Powershellで以下を実行でインストール。
winget install --id=ImageMagick.ImageMagick
ターミナルで
brew install imagemagick
sudo apt install imagemagick
pip install -r requirements.txtのところ)をインストール。
pip install -r requirements.txtがうまく行かないときは、いろいろ自分で頑張って…。Geminiに作ってもらった。※縦書きOCRでしか試していないので、横書きOCRがうまく機能するかは試していないので、あしからず。
メモ帳などのテキストエディタで以下の内容を ocr_pdf_txt.py として保存。
ただし、16行目のC:\YOUR_PATH\ndlocr-lite-master\srcの部分(NDLOCR-Liteのocr.pyが入っているフォルダ)は、自分の環境に合わせて書き換える。
import os
import sys
import glob
import json
import time
import subprocess
import shutil
import fitz  # PyMuPDF
from PIL import Image
from reportlab.pdfgen import canvas
from reportlab.pdfbase import pdfmetrics
from reportlab.pdfbase.cidfonts import UnicodeCIDFont
from reportlab.lib.colors import blue

# --- 設定項目 ---
NDLOCR_REPO_PATH = os.path.abspath(r"C:\YOUR_PATH\ndlocr-lite-master\src")
# ----------------

def create_pdf_from_json(json_path, img_path, output_path):
    """個別PDF生成ロジック(ReportLab)"""
    try:
        with open(json_path, 'r', encoding='utf-8') as f:
            data = json.load(f)
        img = Image.open(img_path)
        img_w, img_h = img.size
        c = canvas.Canvas(output_path, pagesize=(img_w, img_h))
        pdfmetrics.registerFont(UnicodeCIDFont('HeiseiMin-W3', isVertical=True))
        pdfmetrics.registerFont(UnicodeCIDFont('HeiseiKakuGo-W5', isVertical=False))
        c.drawImage(img_path, 0, 0, width=img_w, height=img_h)
        c.setFillColor(blue, alpha=0.0)

        contents = data.get('contents', [[]])[0] if 'contents' in data else []
        for item in contents:
            text = item.get('text', '')
            bbox = item.get('boundingBox', [])
            if not text or not bbox: continue
            x_coords = [p[0] for p in bbox]; y_coords = [p[1] for p in bbox]
            x_min, x_max = min(x_coords), max(x_coords); y_min, y_max = min(y_coords), max(y_coords)
            width, height = x_max - x_min, y_max - y_min
            if height > width:
                font_size = width * 0.7
                x_pdf, y_pdf = x_max - (font_size * 0.7), img_h - y_min
                c.setFont('HeiseiMin-W3', font_size)
                c.drawString(x_pdf, y_pdf, text)
            else:
                font_size = height * 0.7
                x_pdf, y_pdf = x_min, img_h - y_max
                c.setFont('HeiseiKakuGo-W5', font_size)
                c.drawString(x_pdf, y_pdf, text)
        c.save()
        return True
    except Exception as e:
        print(f"Error: {e}"); return False

def main():
    if len(sys.argv) < 2:
        print("使用法: python makeTXT_PDF.py 入力.pdf"); return

    input_pdf = os.path.abspath(sys.argv[1])
    output_name = os.path.splitext(os.path.basename(input_pdf))[0]

    current_dir = os.getcwd()
    target_dir = os.path.join(current_dir, "OCR", "image")
    abs_pdf_dir = os.path.join(current_dir, "OCR", "OCR_PDF")
    abs_txt_dir = os.path.join(current_dir, "OCR", "OCR_TXT")

    for d in [target_dir, abs_pdf_dir, abs_txt_dir]:
        os.makedirs(d, exist_ok=True)

    try:
        # 1. PDF -> PNG (PyMuPDF)
        print("--- 1. PDFを画像に変換中 ---")
        doc_orig = fitz.open(input_pdf)
        for i, page in enumerate(doc_orig):
            pix = page.get_pixmap(matrix=fitz.Matrix(2, 2))
            pix.save(os.path.join(target_dir, f"image-{i+1:03d}.png"))
        doc_orig.close()

        # 追加工程: ImageMagick による傾き補正
        print("--- 1b. 画像の傾きを補正中 (ImageMagick) ---")
        # Windows環境で *.png を正しく処理するため shell=True を使用
        subprocess.run("mogrify -deskew 50% *.png", shell=True, cwd=target_dir, check=True)

        # 2. NDLOCR-Lite 実行
        print("--- 2. NDLOCR-Lite 実行中 ---")
        subprocess.run([
            sys.executable, os.path.join(NDLOCR_REPO_PATH, "ocr.py"),
            "--sourcedir", target_dir,
            "--output", target_dir
        ], cwd=NDLOCR_REPO_PATH, check=True)

        time.sleep(2)

        # 3. 個別PDF生成
        print("--- 3. 個別PDF生成とテキスト抽出 ---")
        json_files = sorted(glob.glob(os.path.join(target_dir, "image-*.json")))
        full_text = ""
        for json_file in json_files:
            base = os.path.splitext(os.path.basename(json_file))[0]
            img_file = os.path.join(target_dir, f"{base}.png")
            pdf_page_out = os.path.join(target_dir, f"{base}.pdf")
            txt_file = os.path.join(target_dir, f"{base}.txt")
            if os.path.exists(img_file): create_pdf_from_json(json_file, img_file, pdf_page_out)
            if os.path.exists(txt_file):
                with open(txt_file, 'r', encoding='utf-8') as f: full_text += f.read() + "\n\n"

        # 4. PDFの結合 (PyMuPDF)
        print(f"--- 4. PDFを結合中: {output_name}.pdf ---")
        combined_pdf = fitz.open()
        page_pdfs = sorted(glob.glob(os.path.join(target_dir, "image-*.pdf")))
        for p_pdf in page_pdfs:
            with fitz.open(p_pdf) as m_pdf: combined_pdf.insert_pdf(m_pdf)

        combined_pdf_path = os.path.join(abs_pdf_dir, f"{output_name}.pdf")
        combined_pdf.save(combined_pdf_path)
        combined_pdf.close()

        # 5. テキスト保存
        with open(os.path.join(abs_txt_dir, f"{output_name}.txt"), "w", encoding="utf-8") as f:
            f.write(full_text)

        print(f"\n完了しました!\n出力: {combined_pdf_path}")

    except Exception as e:
        print(f"エラー: {e}")
    finally:
        # 中間ファイルの削除
        shutil.rmtree(target_dir, ignore_errors=True)
        pass

if __name__ == "__main__":
    main()
ディレクトリ(フォルダ)構成を以下のようにする。
任意ディレクトリ
├─入力.pdf
└─ocr_pdf_txt.py
スクリプトを実行すると自動的に任意ディレクトリの下位ディレクトリにOCRフォルダ、さらに下位ディレクトリにimageフォルダ、OCR_PDFフォルダ、OCR_TXTフォルダを配置してくれる。
PDFやocr_pdf_txt.pyが入っているフォルダ内で右クリック、「ターミナルで開く」でPowerShellを起動。以下を実行。 pdfが各ページごとのpngファイルに変換され、OCR>imageフォルダに入る。
python3 ocr_pdf_txt.py "入力.pdf"
入力.pdfのところは、ドラッグ&ドロップでパス付きファイル名を入れないように。ファイル名をだけを入れること。
OCRフォルダ内の、OCR_PDFフォルダに透明テキスト付PDFが、OCR_TXTフォルダに結合されたテキストファイルが入っているはず。
さらに、たとえばOCRしたいPDFが、1922.01.pdf、1922.02.pdf … のように連番で存在して、それらを一気にOCRしたい場合は、Powershellで以下のようにする。
Get-ChildItem 1922.*.pdf | Sort-Object Name | ForEach-Object {python3 ocr_pdf_txt.py $_.Name}
「OCR-TXT」フォルダ内の全てのtxtファイルを対象に、一瞬でキーワード検索できる。
「OCR-TXT」フォルダ内で右クリック、「ターミナルで開く」でPowerShellを起動。以下のように実行。
Select-String "検索したいキーワード" *.txt | Format-Table Filename, LineNumber, Line
and検索の例
Select-String "師範學校" *.txt | Select-String "鹿兒島" | Format-Table Filename,LineNumber,Line
grep --color=always -n -H "検索したいキーワード" *.txt | column -t -s ":"
and検索の例
grep --color=always -n -H "師範學校" *.txt | grep --color=always -n -H "鹿兒島" | column -t -s ":"
ターミナルのフォントはUDEV Gothicを使うと良い。
yuru7/udev-gothic: UDEV Gothic
※追記:もっと簡単に実行できるように改良した(Geminiに改良してもらった)。
NDLOCR-LiteでOCRして、透明テキストの付いたPDFを作成(端末だけで実行ver2)
国立国会図書館(NDL)がGPUを必要としないOCRツール NDLOCR-Liteアプリケーション を公開した。 https://github.com/ndl-lab/ndlocr-lite
これを利用すると、紙ベースで書類等をスキャンしたPDFデータをOCRできるだけでなく、PDFに透明テキストをつけることができる。
※以前の記事(NDLOCR-LiteでOCRして、透明テキストの付いたPDFを作成)の方法は、コマンドライン(Powershell)とNDLOCR-LiteのGUIを行ったり来たりしながらやらないといけなかったので、今回はコマンドラインのみでできるようにする。
※ただし、縦書きOCRでしか試していないので、横書きOCRがうまく機能するかは試していないので、あしからず。
pip install -r requirements.txtのところ)をインストール。
pip install -r requirements.txtがうまく行かないときは、いろいろ自分で頑張って…。Powershellで以下を実行でインストール。
winget install --id=PDFLabs.PDFtk.Server
ターミナルで
brew install pdftk-java
sudo apt install pdftk-java
初心者がpythonを入れるのは、PCのMicrosoft Storeからインストールのが一番楽だと思う。
PyMuPDFライブラリは、Powershellで以下を実行してインストール。
pip install pymupdf
PDFを各ページごとのpng画像にするためのスクリプト。なお、ChatGPTに作ってもらった。
メモ帳などのテキストエディタで以下の内容を pdftopng.py として保存。
import sys
import os
import fitz
from multiprocessing import Pool, cpu_count

def convert_pages(args):
    pdf_path, pages, outdir = args

    doc = fitz.open(pdf_path)

    for page_num in pages:
        page = doc.load_page(page_num)
        pix = page.get_pixmap(matrix=fitz.Matrix(2,2), alpha=False)
        pix.save(f"{outdir}/image-{page_num+1:04d}.png")

    doc.close()

def main():

    if len(sys.argv) < 2:
        print("使い方: python3 pdftopng.py ファイル名.pdf")
        sys.exit()

    pdf = sys.argv[1]

    if not pdf.lower().endswith(".pdf"):
        pdf += ".pdf"

    outdir = os.path.join("OCR", "image")
    os.makedirs(outdir, exist_ok=True)

    doc = fitz.open(pdf)
    total_pages = len(doc)
    doc.close()

    cores = cpu_count()

    page_lists = [[] for _ in range(cores)]
    for i in range(total_pages):
        page_lists[i % cores].append(i)

    tasks = [(pdf, pages, outdir) for pages in page_lists if pages]

    with Pool(cores) as p:
        p.map(convert_pages, tasks)

if __name__ == "__main__":
    main()
メモ帳などのテキストエディタで、以下の内容を「makeOCR_PDF.py」として保存。
これはGeminiに作成してもらった。
※ただし、縦書きOCRでしか試していないので、横書きOCRがうまく機能するかは試していないので、あしからず。
import json
import os
import sys
import glob
import subprocess
from PIL import Image
from reportlab.pdfgen import canvas
from reportlab.pdfbase import pdfmetrics
from reportlab.pdfbase.cidfonts import UnicodeCIDFont
from reportlab.lib.colors import blue

# --- 基本設定 ---
TARGET_DIR = './OCR/image/'
# 親ディレクトリ基準の保存先
PDF_FINAL_DIR = '../OCR_PDF/'
TXT_FINAL_DIR = '../OCR_TXT/'

def create_pdf_from_json(json_path, img_path, output_path):
    """個別PDF生成ロジック"""
    try:
        with open(json_path, 'r', encoding='utf-8') as f:
            data = json.load(f)
        img = Image.open(img_path)
        img_w, img_h = img.size
        c = canvas.Canvas(output_path, pagesize=(img_w, img_h))
        pdfmetrics.registerFont(UnicodeCIDFont('HeiseiMin-W3', isVertical=True))
        pdfmetrics.registerFont(UnicodeCIDFont('HeiseiKakuGo-W5', isVertical=False))
        c.drawImage(img_path, 0, 0, width=img_w, height=img_h)
        c.setFillColor(blue, alpha=0.0) # 透明設定

        for item in data['contents'][0]:
            text = item['text']
            bbox = item['boundingBox']
            x_coords = [p[0] for p in bbox]; y_coords = [p[1] for p in bbox]
            x_min, x_max = min(x_coords), max(x_coords)
            y_min, y_max = min(y_coords), max(y_coords)
            width, height = x_max - x_min, y_max - y_min

            if height > width: # 縦書き
                font_size = width * 0.7
                x_pdf = x_max - (font_size * 0.7)
                y_pdf = img_h - y_min
                c.setFont('HeiseiMin-W3', font_size)
                c.drawString(x_pdf, y_pdf, text)
            else: # 横書き
                font_size = height * 0.7
                x_pdf = x_min
                y_pdf = img_h - y_max
                c.setFont('HeiseiKakuGo-W5', font_size)
                c.drawString(x_pdf, y_pdf, text)
        c.save()
        return True
    except Exception as e:
        print(f"Error: {e}")
        return False

def main():
    # 1. 引数のチェック
    if len(sys.argv) < 2:
        print("使用法: python3 make.py [出力ファイル名]")
        print("例: python3 make.py sample_01")
        return

    output_name = sys.argv[1] # コマンドラインからの引数

    # 保存先ディレクトリの準備
    abs_pdf_dir = os.path.abspath(os.path.join(TARGET_DIR, PDF_FINAL_DIR))
    abs_txt_dir = os.path.abspath(os.path.join(TARGET_DIR, TXT_FINAL_DIR))
    os.makedirs(abs_pdf_dir, exist_ok=True)
    os.makedirs(abs_txt_dir, exist_ok=True)

    # 2. 個別PDFの生成
    json_files = sorted(glob.glob(os.path.join(TARGET_DIR, "image-*.json")))
    if not json_files:
        print("対象ファイルが見つかりません。")
        return

    for json_file in json_files:
        base = os.path.splitext(os.path.basename(json_file))[0]
        img_file = os.path.join(TARGET_DIR, f"{base}.png")
        pdf_out = os.path.join(TARGET_DIR, f"{base}.pdf")
        if os.path.exists(img_file):
            create_pdf_from_json(json_file, img_file, pdf_out)

    # 3. PDFの結合 (pdftk)
    print(f"PDFを結合中: {output_name}.pdf")
    combined_pdf_path = os.path.join(abs_pdf_dir, f"{output_name}.pdf")
    subprocess.run(f"pdftk *.pdf cat output \"{combined_pdf_path}\"", shell=True, cwd=TARGET_DIR)

    # 4. テキストの結合 (PowerShell)
    print(f"テキストを結合中: {output_name}.txt")
    combined_txt_path = os.path.join(abs_txt_dir, f"{output_name}.txt")
    ps_command = f'Get-Content -Encoding UTF8 .\\*.txt | Out-File -FilePath "{combined_txt_path}" -Encoding UTF8'
    subprocess.run(["powershell", "-Command", ps_command], cwd=TARGET_DIR)

    # 5. 後片付け (削除)
    print("中間ファイルを削除中...")
    extensions = ['*.pdf', '*.txt', '*.png', '*.json', '*.xml']
    for ext in extensions:
        for f in glob.glob(os.path.join(TARGET_DIR, ext)):
            os.remove(f)

    print(f"完了しました。出力先:\n PDF: {combined_pdf_path}\n TXT: {combined_txt_path}")

if __name__ == "__main__":
    main()
ディレクトリ(フォルダ)構成を以下のようにする。
任意ディレクトリ
├─入力.pdf
├─pdftopng.py
├─makeOCR_PDF.py
└─OCR
├─image
├─OCR_PDF
└─OCR_TXT
任意ディレクトリにOCRをしたいPDF、pdftopng.py、makeOCR_PDF.pyを入れ、
その下位ディレクトリにOCRフォルダ、
さらに下位ディレクトリにimageフォルダ、OCR_PDFフォルダ、OCR_TXTフォルダを配置する。
PDFやpdftopng.pyが入っているフォルダ内で右クリック、「ターミナルで開く」でPowerShellを起動。以下を実行。 pdfが各ページごとのpngファイルに変換され、OCR>imageフォルダに入る。
python3 pdftopng.py "入力.pdf"
"入力.pdf"のところは、""(ダブルクォーテーションマーク)の中にカーソルを持ってきて、pdfファイルをドラッグ・アンド・ドロップをすればよい。
ターゲットフォルダ(--sourcedir)OCR>imageフォルダで、出力データ保存先(--output)も同じOCR>imageフォルダで、OCR。
python3 "D:\D_Program_Files\ndlocr-lite-master\src\ocr.py" --sourcedir "D:\Documents\test\OCR\image" --output "D:\Documents\test\OCR\image"
D:\D_Program_Files\ndlocr-lite-master\src\ocr.pyやD:\Documents\test\OCR\imageのところは、自分の環境に合わせて適宜修正を。
OCR後、以下を実行。
OCR_PDFフォルダに透明テキスト付PDFが、OCR_TXTフォルダに結合されたテキストファイルが入って、imageフォルダ内のpdf、txt、png、json、xmlファイルが削除される。
python3 makeOCR_PDF.py 出力ファイル名
「OCR-TXT」フォルダ内の全てのtxtファイルを対象に、一瞬でキーワード検索できる。
「OCR-TXT」フォルダ内で右クリック、「ターミナルで開く」でPowerShellを起動。以下のように実行。
Select-String "検索したいキーワード" *.txt | Format-Table Filename, LineNumber, Line
and検索の例
Select-String "師範學校" *.txt | Select-String "鹿兒島" | Format-Table Filename,LineNumber,Line
grep --color=always -n -H "検索したいキーワード" *.txt | column -t -s ":"
and検索の例
grep --color=always -n -H "師範學校" *.txt | grep --color=always -n -H "鹿兒島" | column -t -s ":"
ターミナルのフォントはUDEV Gothicを使うと良い。
yuru7/udev-gothic: UDEV Gothic
